


Core switches tegelijk uitgevallen? Herstel binnen enkele uren
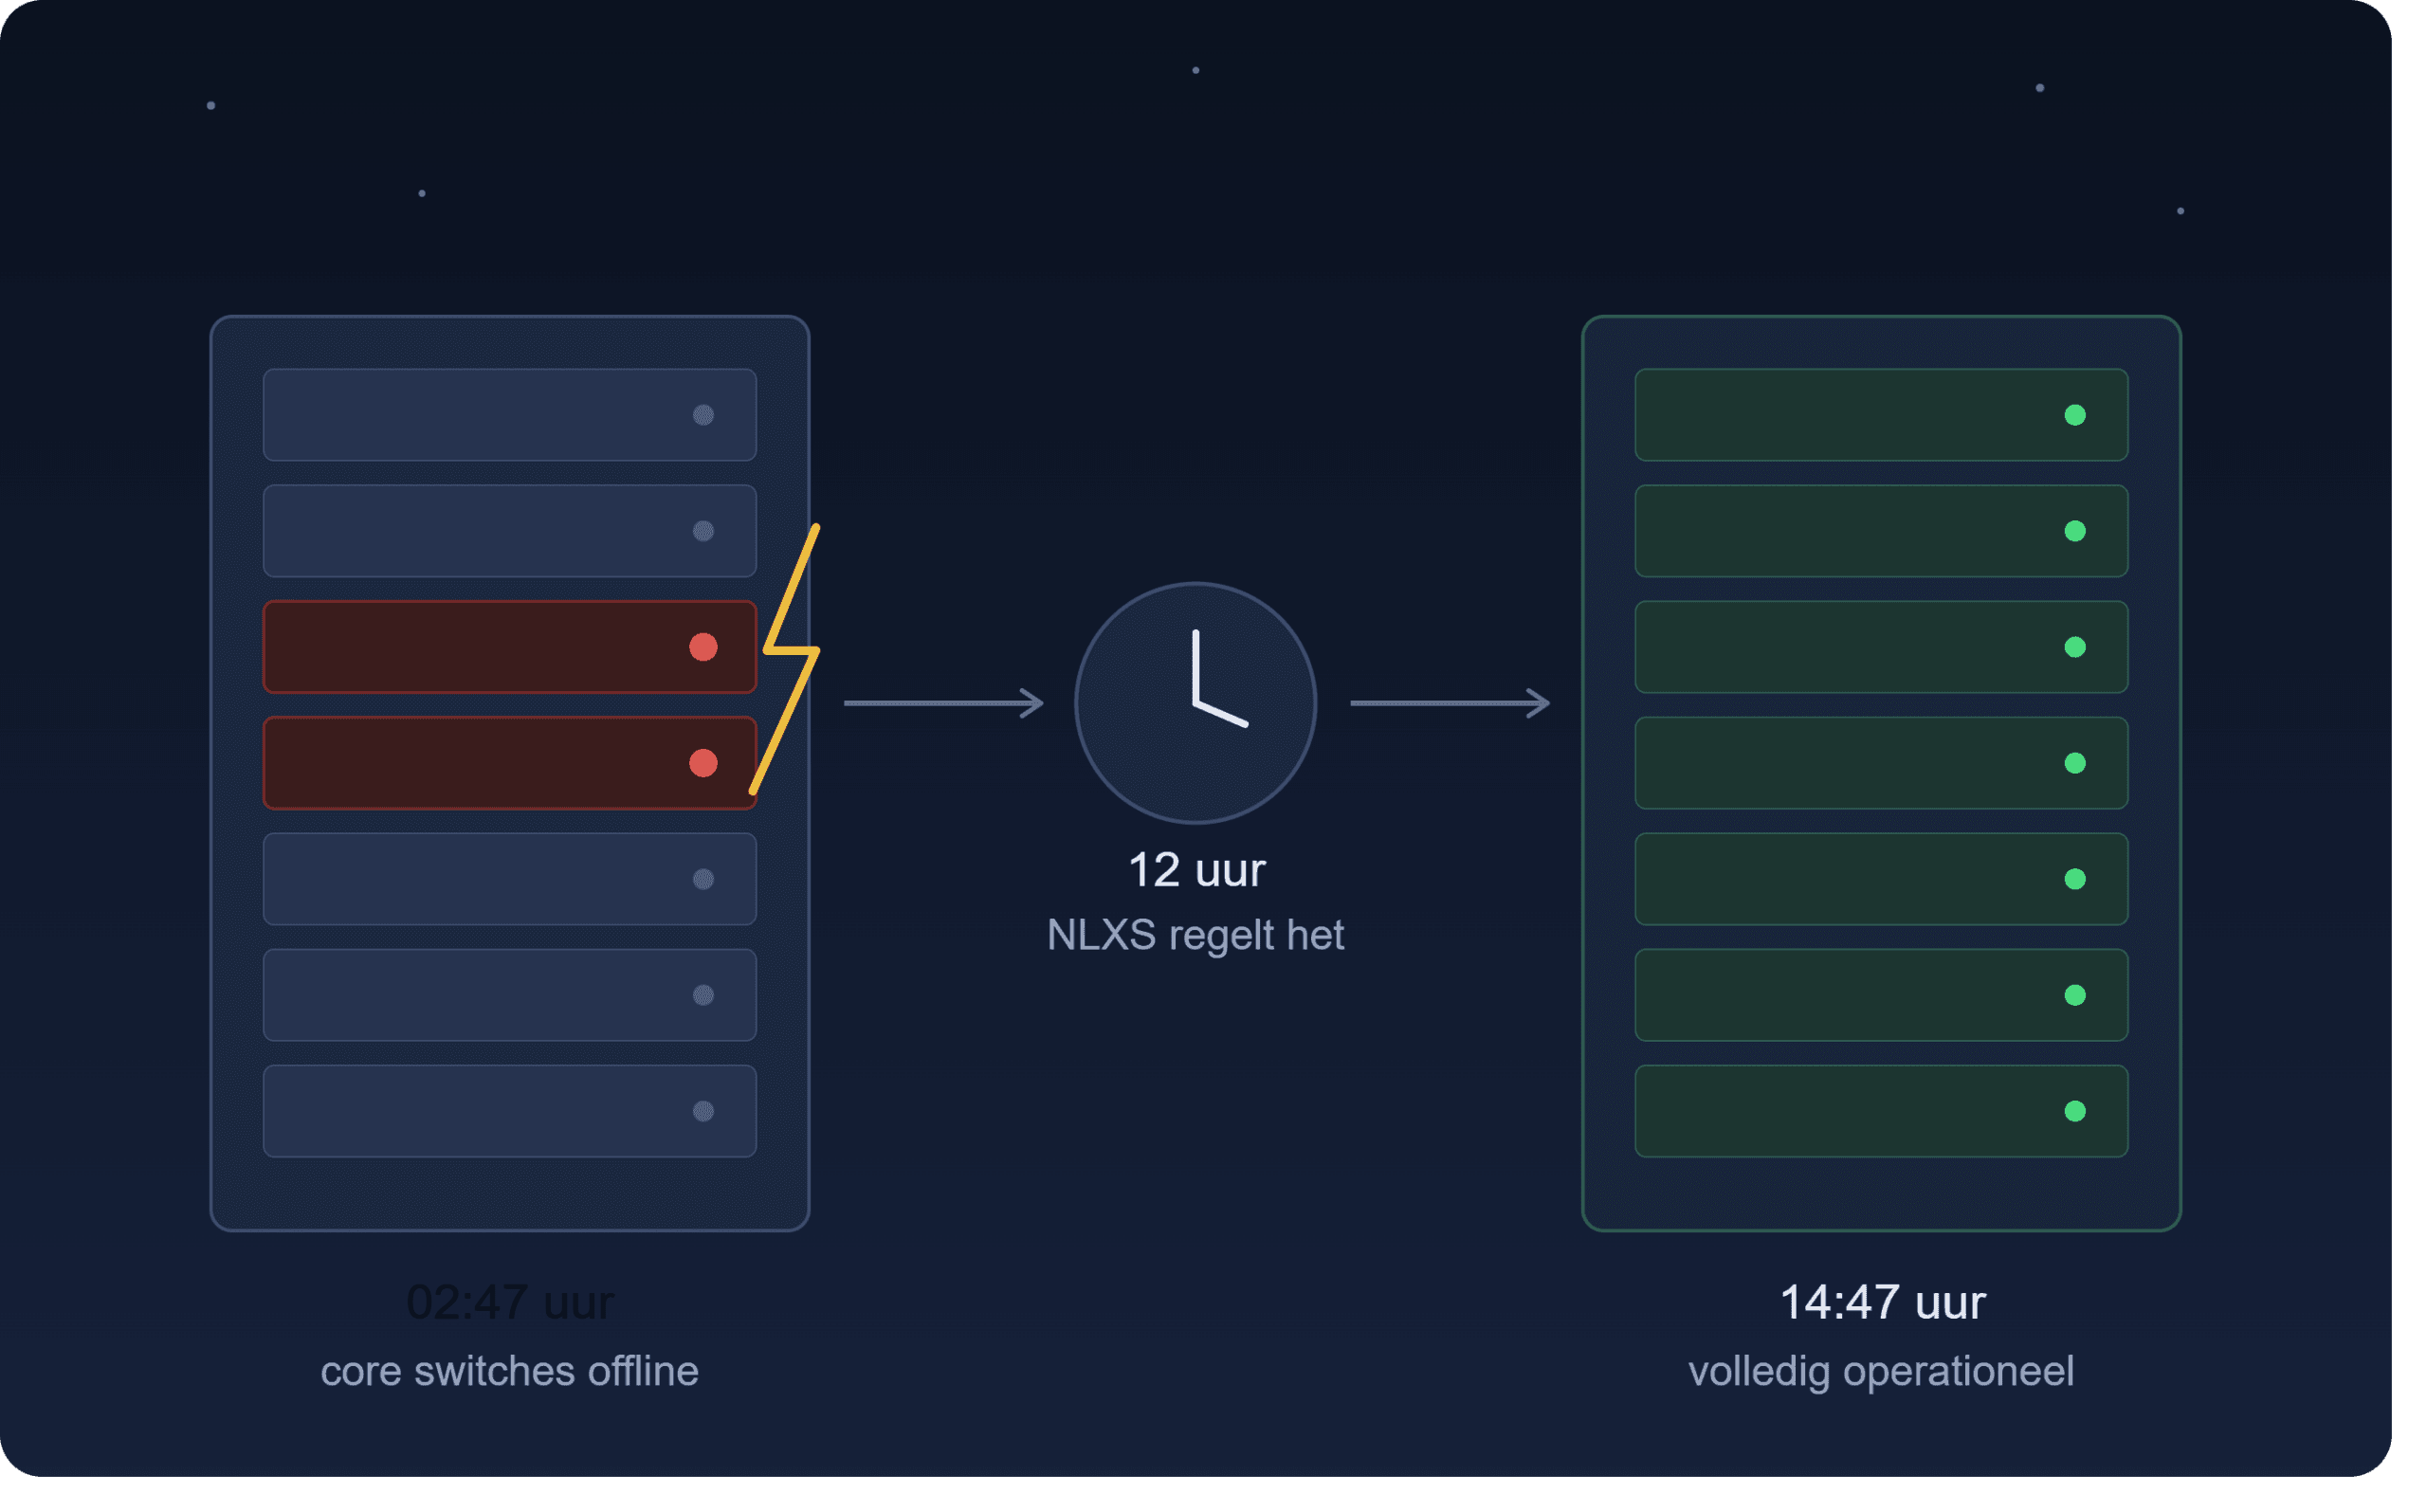
Wat doe je als je dubbel uitgevoerde core switches tegelijk uitvallen?
Kort antwoord: ook bij dubbel uitgevoerde core switches kan een stroompiek beide voedingspaden tegelijk beschadigen, omdat de redundantie in de praktijk vaak afhankelijk is van één gedeelde stroombron of meterkast. NLXS herstelt dit soort kritieke storingen, samen met partners en leveranciers, binnen 12 uur.
02:47 uur. De telefoon van een IT-manager gaat. Niet één keer — continu.
In de serverruimte is de stroom weggevallen. Geen reden tot paniek, denk je dan: alles staat dubbel uitgevoerd. Twee voedingen per rack, twee PDU’s, twee core switches. Volledig redundant, precies zoals het hoort.
Tot het ontwerp tegen de werkelijkheid botst.
Een stroompiek bij het herstel van de netspanning beschadigt namelijk niet één, maar beide voedingspaden tegelijk. De dubbel uitgevoerde core switches — het hart van het netwerk — gaan op hetzelfde moment offline. Niet omdat het ontwerp slecht was, maar omdat de werkelijkheid zich niets aantrekt van een failover-diagram op papier.
Het resultaat: een compleet bedrijf zonder internet, zonder telefonie, zonder interne systemen. Productie stil. Klantenservice plat. Facturatie eruit. En een serverruimte vol kapotte apparatuur die een uur eerder nog kerngezond bij stond.
Dit is geen hypothetisch scenario. Het is een situatie die we in de praktijk hebben zien gebeuren bij grote organisaties — en die vaker voorkomt dan de meeste IT-afdelingen denken.
Waarom faalt dubbele redundantie soms toch?
Redundantie wordt vaak gezien als de ultieme garantie tegen uitval. Twee voedingen, twee switches, twee routes — wat kan er nou misgaan? In theorie niets. In de praktijk genoeg, namelijk wanneer de aanname dat beide paden onafhankelijk zijn niet meer klopt.
Een paar manieren waarop dat misgaat:
- Gedeelde stroombron. Beide voedingspaden komen uiteindelijk samen op dezelfde groep, dezelfde fase of dezelfde UPS. Eén stroompiek raakt dan automatisch beide kanten.
- Gelijktijdige overspanning. Bij het terugkeren van de netspanning na een stroomstoring ontstaat vaak een korte, hevige piek. Apparatuur die op dat moment quasi-gelijktijdig weer inschakelt, krijgt die piek op beide voedingen tegelijk te verwerken.
- Verouderde of niet-gematchte hardware. Voedingen en PDU’s van verschillende leeftijden of merken reageren niet altijd identiek op een spanningspiek — het zwakste onderdeel begeeft het eerst en trekt soms het andere mee.
- Single point of failure buiten het rack. De redundantie stopt vaak bij het rack zelf. Daarachter zit nog altijd één hoofdverdeler, één meterkast, of één UPS-systeem dat niet is meegenomen in het ontwerp.
Het punt is niet dat redundantie nutteloos is — integendeel. Het punt is dat “dubbel uitgevoerd” een vals gevoel van onkwetsbaarheid kan geven, terwijl de zwakke schakel zich ergens anders bevindt dan iedereen had aangenomen.
Wat is de impact van uitgevallen core switches voor een bedrijf?
Wanneer de core switches eruit liggen, is het probleem zelden alleen technisch. Het is bedrijfskritiek.
Denk aan:
- Omzetverlies per uur dat het primaire proces stilligt — van productielijnen tot online verkoopkanalen.
- Klantvertrouwen dat onder druk komt te staan wanneer klantenservice, facturatie of leveringen vastlopen.
- Interne chaos, omdat e-mail, telefonie en interne tools vaak over dezelfde infrastructuur lopen.
- Reputatieschade, zeker wanneer de storing extern zichtbaar wordt — bijvoorbeeld via een niet-bereikbare website of app.
Op zo’n moment heb je niets aan een ticketnummer, een SLA-document dat een reactietijd van vijf werkdagen belooft, of een leverancier die “er zo snel mogelijk naar kijkt”. Je hebt mensen nodig die onmiddellijk schakelen.
Hoe herstelt NLXS een kritieke storing binnen zeer korte tijd?
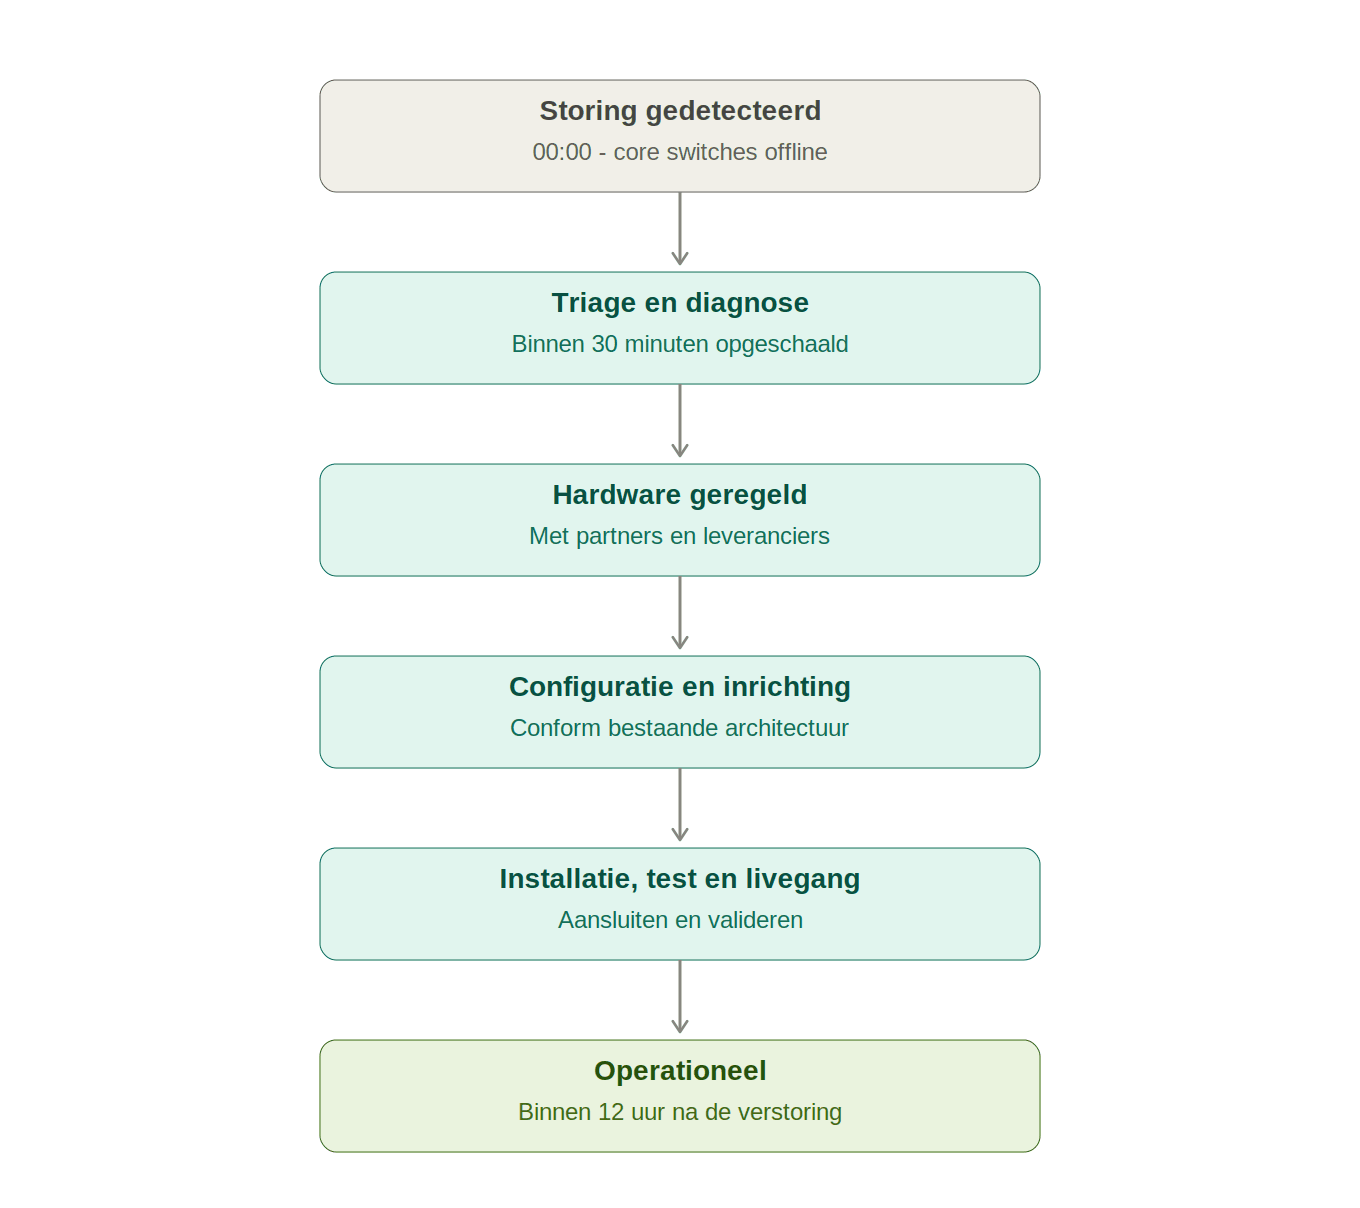
NLXS begeleidt grote organisaties bij precies dit soort kritieke verstoringen. Niet met een dik rapport achteraf, maar met de handen uit de mouwen, vanaf het eerste moment.
1. Triage en diagnose (binnen 30 minuten) Direct na de melding wordt vastgesteld wat er kapot is, waarom de redundantie tóch heeft gefaald, en wat er minimaal nodig is om het bedrijf weer online te krijgen.
2. Hardware regelen via partners en leveranciers NLXS schakelt direct met het eigen netwerk van partners en leveranciers om vervangende hardware te vinden — core switches, voedingen, PDU’s — vaak binnen enkele uren beschikbaar, ook buiten kantoortijden.
3. Configuratie en inrichting De nieuwe apparatuur wordt geconfigureerd conform de bestaande netwerkarchitectuur, zodat er geen nieuwe kwetsbaarheden ontstaan en de oorspronkelijke (of verbeterde) redundantie-opzet intact blijft.
4. Installatie, test en livegang Aansluiten, testen, valideren — pas wanneer alles aantoonbaar stabiel draait, wordt het bedrijf weer volledig op het netwerk gezet.
5. Operationeel binnen 12 uur Het doel is hard: binnen 12 uur na de verstoring is de organisatie weer volledig operationeel, met werkende, geconfigureerde en geteste apparatuur.
Geen eindeloze escalatiematrix. Geen “we nemen het mee in de volgende sprint”. Gewoon pragmatisch, professioneel en snel het probleem oplossen, zodat het bedrijf weer door kan.
Hoe voorkom je dat dubbele redundantie toch faalt?
Een incident als dit is ook een gratis stresstest van je infrastructuur. Een paar vragen die elke organisatie zichzelf zou moeten stellen:
- Zijn onze twee voedingspaden écht onafhankelijk, tot en met de meterkast?
- Hebben we ooit getest wat er gebeurt bij een gelijktijdige stroomterugkeer na een storing?
- Weten we, vóór het incident, wie we bellen als de standaardprocedure niet werkt?
- Hebben we een partij achter de hand die niet alleen adviseert, maar ook daadwerkelijk binnen uren kan leveren, configureren en aansluiten?
Dat laatste is precies waar NLXS het verschil maakt: niet alleen het opstellen van een herstelplan, maar het daadwerkelijk uitvoeren ervan, samen met de juiste partners, op het moment dat het er echt toe doet.
Tot slot
Een totale uitval van je core-infrastructuur overkomt iedereen — hoe goed je ontwerp ook is. Het verschil tussen een vervelende nacht en een bedrijfscrisis van dagen zit in hoe snel en hoe gestructureerd er gehandeld wordt zodra het misgaat.
Heb jij weleens zo’n nacht meegemaakt? Of ben je verantwoordelijk voor infrastructuur waarvan je ’s nachts wakker zou kunnen liggen? Neem gerust contact op met NLXS om te bespreken hoe jouw organisatie zich kan voorbereiden op — of kan herstellen van — dit soort kritieke verstoringen.
Meer weten over hoe NLXS organisaties begeleidt bij kritieke IT-verstoringen? Bekijk onze diensten rondom incident response of neem direct contact op.
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.