


6 stappen naar servers met hoge beschikbaarheid voor beslissers en IT

High availability servers houden bedrijfskritische diensten draaiend door redundantie, replicatie en automatische failover te combineren. In de praktijk betekent dit dat een storing in één component, zoals een voedingseenheid of een netwerkpad, geen impact heeft op de dienst zelf. Bedrijven die hun RTO en RPO scherp definiëren en die vastleggen in een SLA, voorkomen niet alleen downtime maar besparen ook op de kosten van incidenten.
Kort samengevat:
- Een hoog beschikbare serverarchitectuur lost storingen op componentniveau op binnen seconden tot enkele minuten, terwijl disaster recovery uren nodig heeft voor volledige herstel.
- Redundantie, replicatie en failover zijn essentiële bouwstenen; zonder één van deze elementen verliest de omgeving haar betrouwbaarheid.
- Kies bij lage complexiteit voor active-passieve systemen en vermijd active‑active of geo-redundantie tenzij de workload dit echt vereist.
- De kosten voor hogere beschikbaarheid nemen exponentieel toe per extra “nines”, vooral wanneer RTO en RPO een hogere investering rechtvaardigen.
- Een gestructureerd testprotocol en periodieke failover-drills voorkomen dat de werkelijke beschikbaarheid lager is dan verwacht, vooral door implementatie van chaos engineering.
Inhoudsopgave
- Wat high availability servers technisch inhouden
- Kerncomponenten: redundantie, replicatie, failover en fouttolerantie
- Active-passive, active-active of geo-redundantie: welke architectuur past bij jouw workload?
- Wat kost hoge beschikbaarheid en wanneer is het rendabel?
- Implementatiechecklist voor betrouwbare high availability servers
- Wanneer een managed partner zoals NLXS de juiste keuze is
- Beveiligingsaspecten en risico’s van high availability systemen
- Populaire technologieën en tools voor high availability
- Voorbeelden van succesvolle high availability implementaties
- Waarom eenvoud vaker wint dan bedrijven willen toegeven
- Hoge beschikbaarheid uitbesteden aan NLXS
- Bronnen
Wat high availability servers technisch inhouden
Een high availability server is geen los apparaat, maar een architectuur waarin componenten elkaar kunnen vervangen zonder dat de dienst merkbaar stopt. Dat verschilt fundamenteel van disaster recovery. High availability voorkomt downtime door redundantie en directe failover binnen dezelfde of gekoppelde omgevingen, terwijl disaster recovery het herstelplan is voor een volledige uitval van een site, bijvoorbeeld door brand, ransomware of een natuurramp, zoals ook AWS in zijn whitepaper over disaster recovery onderscheidt.
Het verschil zit in de tijdshorizon en de schaal van het probleem:
- HA lost storingen op componentniveau op binnen seconden tot enkele minuten.
- DR herstelt een volledige omgeving, vaak binnen uren, na een catastrofale gebeurtenis.
- HA en DR zijn complementair: Microsoft benadrukt in zijn richtlijnen voor bedrijfscontinuïteit dat organisaties beide nodig hebben, niet als vervanging van elkaar.
Pro-tip: Reken uptime niet in percentages, maar in minuten downtime per jaar. Bij 99,9% beschikbaarheid (“drie nines”) accepteer je ruim 8,7 uur uitval per jaar; bij 99,99% is dat nog geen uur. Die stap kost vaak veel meer dan hij oplevert, tenzij je RTO en RPO dat rechtvaardigen.
Kerncomponenten: redundantie, replicatie, failover en fouttolerantie
Een betrouwbare HA‑omgeving steunt op vier bouwstenen die elkaar versterken. Zonder een van deze schakels wordt de rest van de architectuur zinloos.
- Hardwareredundantie: dubbele voedingen, gescheiden netwerkpaden en storage in RAID‑ of gedistribueerde configuraties elimineren single points of failure.
- Replicatie: synchrone replicatie garandeert een RPO van bijna nul, maar verhoogt latency omdat elke schrijfactie op meerdere knooppunten moet worden bevestigd. Asynchrone replicatie is sneller, maar accepteert een kleine kans op dataverlies bij een crash.
- Failover: health checks en load balancers detecteren uitval en routeren verkeer automatisch naar een gezonde node, zonder handmatige tussenkomst.
- Fouttolerantie via applicatieontwerp: stateless applicaties, waarbij sessiedata buiten de rekenlaag wordt opgeslagen, maken failover eenvoudiger omdat elke node inwisselbaar is.
Pro-tip: Test replicatie niet alleen op snelheid, maar ook op consistentie na een geforceerde stroomonderbreking. Veel teams ontdekken pas tijdens een echte storing dat asynchrone replicatie een paar seconden aan transacties heeft achtergelaten.
Active-passive, active-active of geo-redundantie: welke architectuur past bij jouw workload?
De keuze tussen architectuurpatronen bepaalt hoeveel complexiteit je erbij krijgt voor elke procent extra beschikbaarheid.
- Active-passive houdt één actieve node en één of meer stand‑by nodes klaar. Bij uitval schakelt het systeem over, met een korte onderbreking van seconden tot een paar minuten. Dit patroon is eenvoudig te beheren en past bij de meeste mkb‑omgevingen en interne applicaties.
- Active-active verdeelt verkeer gelijktijdig over meerdere actieve nodes, waardoor uitval van één node vrijwel onmerkbaar is. De prijs is hogere complexiteit: zonder sterke consensusprotocollen ontstaat het risico op split‑brain, waarbij twee nodes tegelijk denken dat zij de enige actieve node zijn. Nobl9 wijst in zijn gids voor high availability design op precies dit risico en adviseert eenvoud boven overengineering wanneer het niet strikt nodig is.
- Geo-redundantie spreidt infrastructuur over meerdere datacenters of regio’s. Dit beschermt tegen uitval op datacenterniveau, zoals stroomstoringen of natuurgeweld, en is vaak verplicht bij strengere compliance‑eisen in gereguleerde sectoren.
Kies active‑passive als startpunt tenzij de workload een aantoonbare zakelijke reden heeft voor active‑active. Complexiteit die niemand kan beheren, is geen beschikbaarheid, het is een nieuw risico.
Wat kost hoge beschikbaarheid en wanneer is het rendabel?
Elke extra “nine” in je uptime-doel kost exponentieel meer dan de vorige. De stap van 99,9% naar 99,99% beschikbaarheid vraagt vaak een volledig nieuwe laag aan redundantie, monitoring en testprocedures, terwijl het verschil in daadwerkelijke uitvaltijd nog geen uur per jaar is. AWS beschrijft deze afweging in de Reliability-pijler van het Well-Architected Framework als een kernvraag die vooraf beantwoord moet worden, niet achteraf.
De rekensom wordt concreet zodra je RTO en RPO omzet naar euro’s. Een CFO-vriendelijk kostenmodel voor downtime laat zien hoe je omzetverlies, SLA-boetes en herstelkosten combineert tot één cijfer waarmee een investeringsbeslissing te onderbouwen is. Gemiddelde kosten per uur serveruitval liggen voor veel ondernemingen aanzienlijk hoger dan bestuurders vooraf inschatten, wat de businesscase voor gerichte investeringen in HA vaak snel sluitend maakt.
- Bepaal per workload apart welke beschikbaarheid nodig is, niet elk systeem verdient dezelfde “nines”.
- Documenteer SLO’s en SLA’s met concrete cijfers, niet met vage beloftes.
- Plan audits en teststructuren met een vaste frequentie, niet ad hoc.
- Vermijd investeringen in extra beschikbaarheid zonder een RTO/RPO die dat rechtvaardigt.
Implementatiechecklist voor betrouwbare high availability servers
Een HA-omgeving bouwen is één ding, hem betrouwbaar houden is een ander verhaal. Deze volgorde werkt in de praktijk het best.
- Bepaal de kritikaliteit per workload. Niet elke applicatie heeft dezelfde bescherming nodig; decompositie van systemen bespaart budget en complexiteit.
- Leg infrastructuur vast als code. Templates voor servers, netwerken en load balancers voorkomen configuratiedrift tussen omgevingen.
- Configureer failover-mechanismen. Denk aan DNS-failover, load balancers met health checks en correct ingestelde replicatie tussen nodes.
- Test met failover-drills en chaos engineering. Simuleer bewust uitval van een node, een netwerkpad of een hele regio om te zien of de failover werkelijk werkt zoals bedoeld.
- Zet observability op. Combineer metrics, tracing en gecentraliseerde logging zodat afwijkingen zichtbaar zijn voordat gebruikers ze merken.
- Schrijf runbooks en rapporteer op SLA-niveau. Elke storing moet een vastgelegde procedure hebben, en elke maand een cijfermatige terugkoppeling.
Pro-tip: Plan chaos engineering niet als eenmalig project maar als terugkerend ritueel, bijvoorbeeld elk kwartaal. Een failover die een jaar geleden werkte, werkt niet automatisch nog steeds na drie infrastructuurupdates.
Wanneer een managed partner zoals NLXS de juiste keuze is
Niet elk bedrijf heeft het team of de tijd om failover-drills, replicatieconfiguraties en SLA-rapportages zelf structureel te onderhouden. Dat is precies waar een partij als NLXS het verschil maakt: problemen worden binnen één dag opgepakt in plaats van de langere responstijden die bij veel andere partijen gangbaar zijn.
- Klanten zoals TU Eindhoven en JCI Breda draaien op infrastructuur die NLXS afstemt op hun specifieke continuïteitseisen.
- Een gratis ICT-scan brengt in kaart waar redundantie ontbreekt en waar budget wordt verspild aan overbodige complexiteit.
- NLXS denkt mee over RTO- en RPO-doelen, stelt testschema’s op en bewaakt de operationele kant zodat IT-teams zich op hun kernactiviteiten kunnen richten.
- Transparante maandtarieven zonder verrassingen maken de kosten van hoge beschikbaarheid voorspelbaar in plaats van een verrassing achteraf.
Wie liever niet zelf failover-scenario’s blijft testen, vindt bij NLXS als ICT-partner een structurele plek om die verantwoordelijkheid neer te leggen.
Beveiligingsaspecten en risico’s van high availability systemen
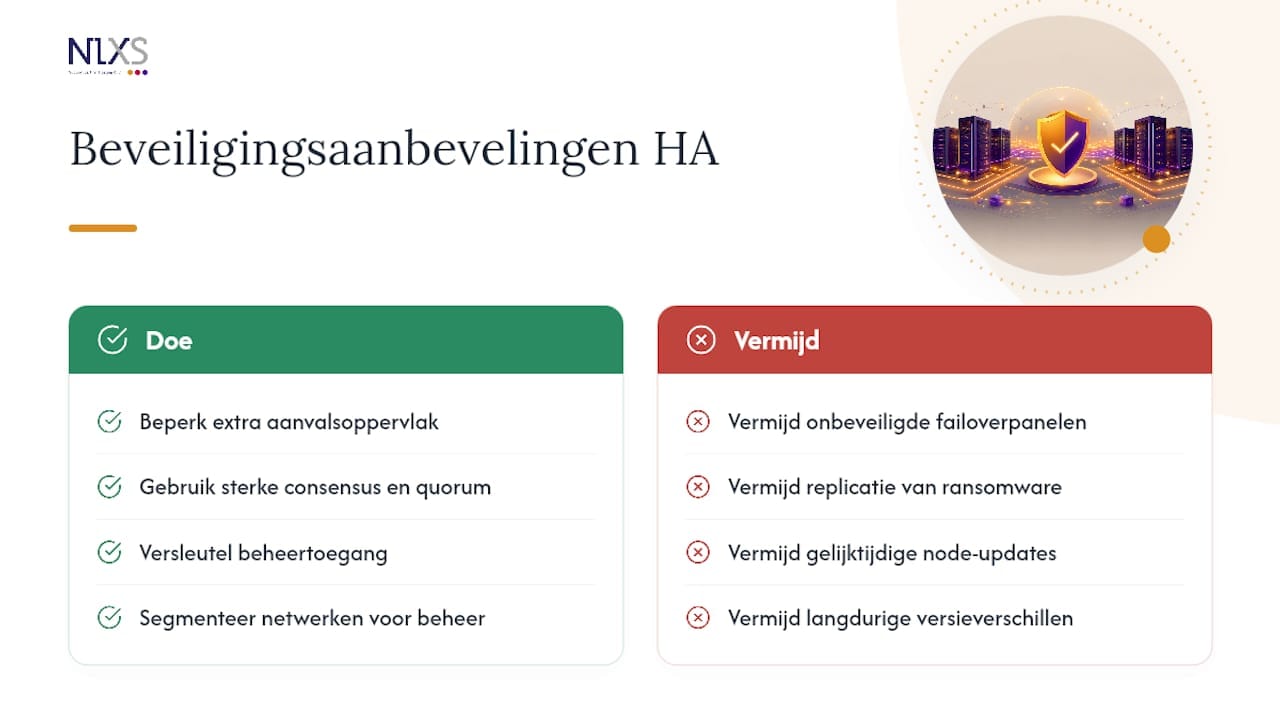
Meer redundantie betekent niet automatisch meer veiligheid. Elke extra node, elk extra netwerkpad en elke replicatieverbinding is ook een extra aanvalsoppervlak. Een systeem dat synchroon repliceert tussen twee locaties, kan bijvoorbeeld ransomware net zo snel naar de tweede locatie repliceren als legitieme data, wat een HA-opzet in dat scenario juist averechts laat werken.
Split-brain-situaties, waarbij twee nodes tegelijk denken de enige actieve node te zijn, vormen niet alleen een operationeel risico maar ook een beveiligingsrisico: conflicterende schrijfacties kunnen leiden tot inconsistente toegangsrechten of verweesde sessies. Sterke consensusprotocollen en strikte quorumregels beperken dat risico aanzienlijk, maar vereisen wel dat ze correct zijn geconfigureerd en periodiek getest worden.
Automatische failover-mechanismen moeten daarnaast zelf beveiligd zijn. Een load balancer of DNS-failoversysteem dat via een onbeveiligd beheerpaneel te benaderen is, wordt een aantrekkelijk doelwit: wie dat paneel overneemt, kan verkeer omleiden naar een kwaadaardige node. Versleutelde beheerkanalen, sterke authenticatie en gescheiden netwerksegmenten voor beheertoegang zijn daarom net zo essentieel als de redundantie zelf.
Ook patchbeheer wordt complexer in een HA-omgeving. Updates moeten rolling worden uitgevoerd, node voor node, zodat de dienst beschikbaar blijft. Dat verlengt het venster waarin verschillende nodes op verschillende softwareversies draaien, met kans op onverwachte incompatibiliteiten tussen replicatielagen.
Populaire technologieën en tools voor high availability
Voor clustering en failoverbeheer zijn Pacemaker met Corosync, Keepalived en de ingebouwde clusteringfunctionaliteit van virtualisatieplatforms als VMware vSphere veelgebruikte keuzes. Ze bewaken de status van nodes en initiëren automatisch een failover zodra een health check faalt.
Load balancing wordt vaak ingevuld met HAProxy, NGINX Plus of een cloud-load balancer die verkeer verdeelt over meerdere gezonde instanties. Deze laag is meestal ook de plek waar DNS-failover wordt getriggerd, zodat gebruikers automatisch naar een werkende locatie worden geleid zonder dat ze daar iets van merken. Zakelijke DNS-failoveroplossingen sluiten hier direct op aan.
Voor observability raadt Flexential in zijn analyse van HA-architectuur een combinatie aan van Prometheus voor metrics en OpenTelemetry voor tracing, aangevuld met een gecentraliseerde log-store. Die combinatie maakt het mogelijk om afwijkend gedrag te signaleren voordat het een storing wordt, in plaats van pas te reageren nadat gebruikers al klachten melden.
Containerorkestratie met Kubernetes voegt daar een extra laag bovenop: pods worden automatisch herstart of verplaatst bij falen van een node, wat de basis legt voor stateless, makkelijk te herstellen applicaties. Wie liever geen eigen cluster beheert, kan die verantwoordelijkheid onderbrengen bij servermonitoring en beheer door een externe partij.
Voorbeelden van succesvolle high availability implementaties
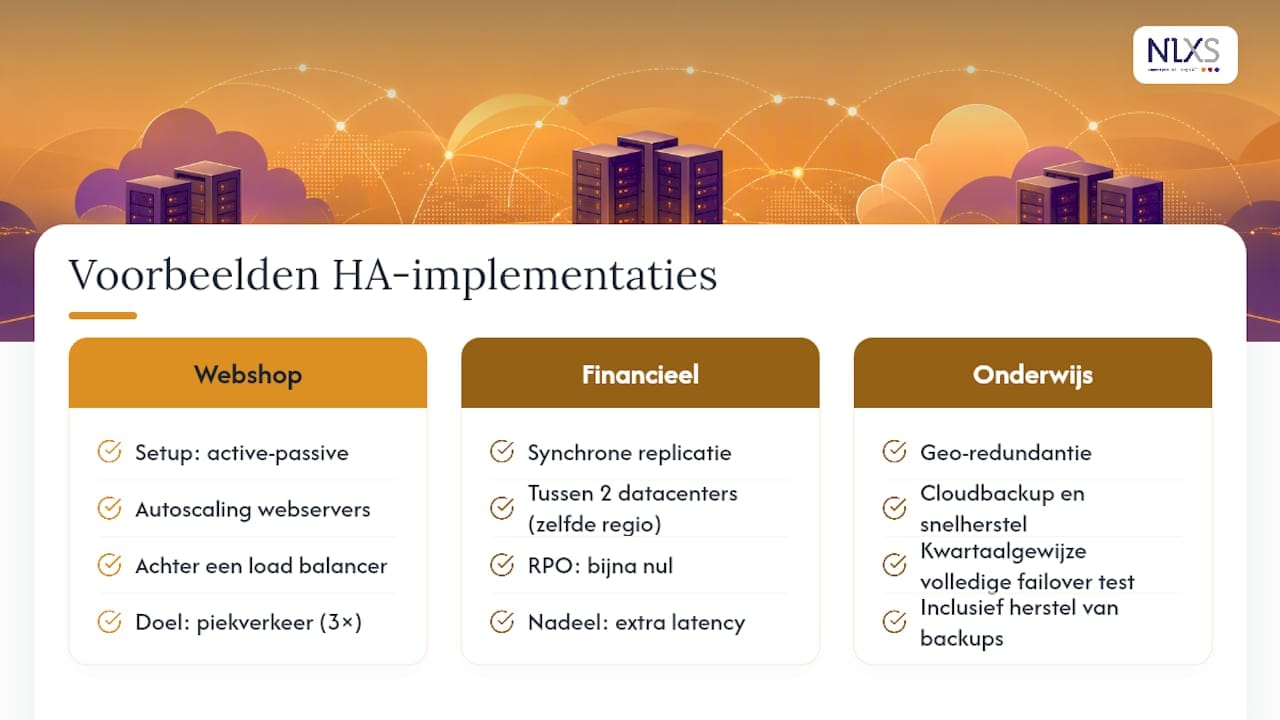
Een webshop die tijdens piekperiodes, zoals Black Friday, plotseling drie keer zoveel verkeer verwerkt, heeft doorgaans een active-passive opzet met automatische opschaling van webservers achter een load balancer. Zodra de primaire node overbelast raakt, neemt een extra instantie het verkeer over zonder dat klanten een onderbroken bestelproces zien. Dat scenario illustreert waarom schaling van servers en high availability in de praktijk nauw samenhangen: beide lossen op wat gebeurt als vraag de capaciteit van één node overschrijdt.
In de financiële sector, waar transacties niet verloren mogen gaan, kiezen organisaties vaker voor synchrone replicatie tussen twee datacenters binnen dezelfde regio. De latency die dat kost, wordt geaccepteerd omdat een RPO van bijna nul zwaarder weegt dan een paar milliseconden extra verwerkingstijd.
Onderwijsinstellingen met kritieke onderzoeksdata combineren vaak geo-redundantie met een strikt testschema: elk kwartaal wordt een volledige failover naar de secundaire locatie gesimuleerd, inclusief het herstellen van backups. Dat soort gestructureerde testfrequenties, zoals ook aanbevolen in de best practices van Nobl9, is wat een HA-ontwerp op papier onderscheidt van een HA-ontwerp dat in de praktijk daadwerkelijk werkt. Cloudbackup en snelherstel spelen daarin een cruciale rol, zoals beschreven in deze gids voor mkb-bedrijven.
Waarom eenvoud vaker wint dan bedrijven willen toegeven
De gangbare aanname is dat meer redundantie altijd beter is. Dat klopt niet. Elke extra laag complexiteit in een HA-ontwerp is ook een extra plek waar iets kan misgaan, en veel organisaties betalen voor active-active-architecturen die ze niet nodig hebben en niet volledig begrijpen.
Wat mij opvalt in de meeste implementaties, is dat teams veel tijd steken in het bouwen van redundantie en nauwelijks tijd in het testen ervan. Een failover die nooit gesimuleerd is, is in de praktijk een onbewezen aanname. Chaos engineering en periodieke failover-drills zijn geen luxe voor grote techbedrijven, ze zijn de enige manier om te weten of je RTO klopt met de werkelijkheid.
De prioriteit voor de meeste bedrijven ligt niet bij meer “nines”, maar bij het juist toewijzen van beschikbaarheid per workload. Een interne rapportagetool heeft geen 99,99% nodig. Een betaalproces in een webshop misschien wel. Wie dat onderscheid niet maakt, betaalt te veel voor bescherming die nergens toe dient, of te weinig voor het systeem dat er echt op aankomt.
— Ken
Hoge beschikbaarheid uitbesteden aan NLXS
NLXS is het alternatief voor bedrijven die geen eigen team willen optuigen voor failover-testen, replicatiebeheer en SLA-rapportage: één aanspreekpunt regelt het geheel, met een reactietijd binnen één dag in plaats van de langere wachttijden die bij veel andere ICT-partijen gebruikelijk zijn.
Dat begint met inzicht. Een gratis ICT-scan brengt in kaart waar jouw huidige infrastructuur single points of failure heeft en waar redundantie ontbreekt of overbodig is. Op basis daarvan stelt NLXS een architectuur voor die past bij de werkelijke kritikaliteit van je workloads, niet bij een onderbuikgevoel over “meer is beter”. Klanten zoals TU Eindhoven en JCI Breda draaien al op infrastructuur die zo is ingericht, met transparante maandtarieven zonder verrassingen achteraf.
Wil je weten waar jouw omgeving kwetsbaar is voordat een storing dat voor je uitzoekt? Plan een gratis ICT-scan en krijg binnen korte tijd een concreet beeld van de risico’s en de kosten om ze op te lossen.
Bronnen
- High availability is not disaster recovery
- A best practices guide to high availability design
- Worldwide enterprise server hourly downtime cost (Statista)
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.