


ICT-escalatieproces: stappenplan voor servicedesk en IT-teams
Een effectief ICT-escalatieproces zorgt dat een incident binnen afgesproken tijd bij de juiste persoon terechtkomt, zonder dat de regie verloren gaat. Dat betekent: één escalatie-eigenaar met een vaste back-up, heldere niveaus en triggers, en vaste communicatiekanalen. Stel dat vandaag nog in, voordat het volgende incident daar om vraagt. Richtlijnen zoals ISO/IEC 27035-1 en de praktijk bij klanten als TU Eindhoven laten zien wat daarbij werkt.
Kort samengevat:
- Zonder vastgelegde criteria en tijdslimieten leidt escalatie in ICT tot willekeur en inefficiëntie, waardoor korte responsetijden niet altijd gegarandeerd zijn.
- De drie gebruikelijke escalatielagen (L1, L2 en L3) moeten duidelijk worden vastgelegd, inclusief back-up contacts, om chaos bij grote incidenten te voorkomen.
- Automatisering van escalaties via tools als Jira Service Management zorgt dat incidenten automatisch doorstromen zodra tijdslimieten verstrijken, en voorkomt menselijke vertraging.
- Regelmatige oefeningen zoals tabletop-sessies bevestigen dat het escalatieproces snel en gestructureerd wordt uitgevoerd en gerichte bijsturing mogelijk maakt.
- Post-incident reviews met focus op doorlooptijden en verbeteracties helpen teams herhaling van dezelfde incidenten te voorkomen en de efficiëntie van het escalatieproces te vergroten.
Inhoudsopgave
- Wat betekent escalatie binnen ICT precies?
- Escalatieniveaus: L1, L2, L3 en andere indelingen
- Wanneer escaleer je: criteria en tijdsregels
- Rollen en verantwoordelijkheden tijdens een escalatie
- Communicatie en rapportage tijdens een incident
- Stappenplan: zo richt je een escalatiepad in
- Nazorg: post-incident review en lessons learned
- Hoe NLXS escalatie in de praktijk ondersteunt
- Wat telt het zwaarst bij het inrichten van escalatie?
- Hoe NLXS kan ondersteunen bij escalatie en herstel
- Veelgestelde vragen
- Bronnen
Wat betekent escalatie binnen ICT precies?
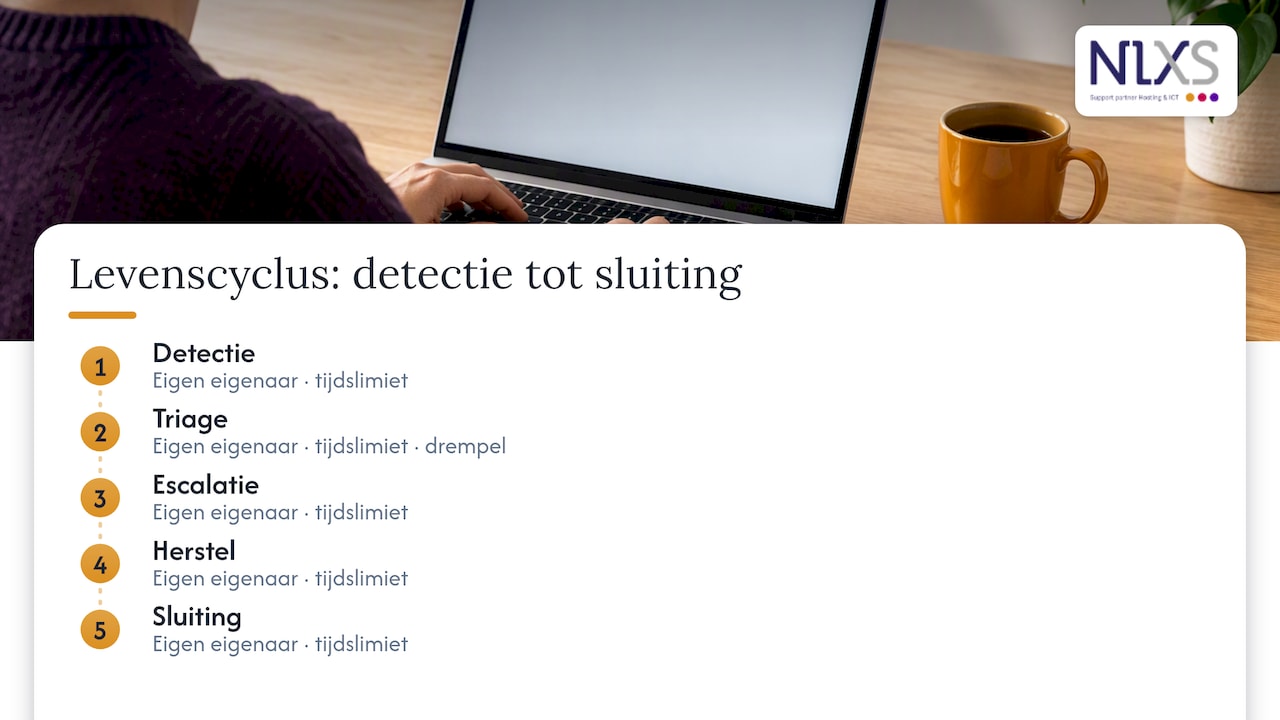
Escalatie binnen ICT is het moment waarop een incident de kennis, bevoegdheid of capaciteit van de eerste behandelaar overstijgt en naar een hoger niveau of een andere rol gaat. De levenscyclus is daarbij steeds hetzelfde: detectie, triage, escalatie, herstel en sluiting. Elke fase heeft een eigen eigenaar en een eigen tijdslimiet, en pas wanneer die limiet of de impact de vooraf afgesproken grens overschrijdt, volgt escalatie.
Het is belangrijk onderscheid te maken tussen het probleemtype en het escalatiebeleid zelf. Een storing in de e-mailserver vraagt om een andere technische route dan een beveiligingsincident, maar het escalatiebeleid (wie beslist, wie communiceert, welke klok loopt) blijft hetzelfde raamwerk. De norm ISO/IEC/IEEE 23612:2026 beschrijft een generiek incidentmanagementproces dat organisaties kunnen gebruiken om die scheiding tussen inhoud en proces te standaardiseren, terwijl tools zoals Jira Service Management van Atlassian dat proces in de praktijk ondersteunen met geautomatiseerde waarschuwingen en overdrachten.
Escalatieniveaus: L1, L2, L3 en andere indelingen
De meeste servicedesks werken met drie lagen, elk met een eigen rol in de keten.
- L1 (servicedesk): registreert, classificeert en lost bekende, veelvoorkomende problemen op, zoals wachtwoordresets of printerstoringen.
- L2 (specialisten): behandelt technisch complexere meldingen, bijvoorbeeld netwerkconfiguraties of applicatiefouten die L1 niet kan oplossen.
- L3 (engineering of leverancier): grijpt in bij structurele of architecturale problemen, zoals een defecte storage-cluster of een kwetsbaarheid in broncode.
Naast deze hiërarchische laag bestaat functionele escalatie, waarbij een melding naar een ander specialisme gaat zonder per se naar een hoger niveau te springen, en automatische escalatie, waarbij een tool zoals Jira Service Management een ticket na een vastgestelde tijd zelf doorzet als niemand heeft gereageerd. Welke vorm je kiest, hangt af van de grootte van het team en de complexiteit van de omgeving.
Wanneer escaleer je: criteria en tijdsregels
Escaleren op gevoel leidt tot willekeur. Werk daarom met vooraf vastgelegde criteria die iedereen in het team hetzelfde interpreteert.
- Impact bepalen: hoeveel personen of bedrijfsprocessen raakt de storing, en is er een compliance- of veiligheidsrisico?
- Urgentie koppelen aan impact: een storing met hoge impact en hoge urgentie (bijvoorbeeld een offline webshop tijdens piekuren) escaleert direct, een storing met lage impact kan wachten op het reguliere oppakmoment.
- Tijdslimieten vastleggen: stel een acknowledgement-tijd (hoe snel iemand reageert) en een resolve-tijd (hoe snel het probleem opgelost moet zijn) per prioriteitsklasse vast.
- Automatisch doorschakelen: laat het systeem escaleren zodra een tijdslimiet verstrijkt, in plaats van te wachten op een handmatige melding.
- Management inschakelen: bij reputatieschade, datalekken of een uitval die langer duurt dan de afgesproken resolve-tijd gaat de melding automatisch naar een manager.
Deze aanpak, waarbij classificatie, impact en escalatie met volledige context worden doorgegeven, sluit aan op de praktijk die Atlassian beschrijft voor escalatiebeleid.
Rollen en verantwoordelijkheden tijdens een escalatie
Zonder duidelijke rollen ontstaat chaos zodra meerdere mensen tegelijk aan een incident werken. Leg daarom vooraf vast wie wat doet.
- Servicedesk-eigenaar: houdt het ticket en de klantcommunicatie in eigen hand, ook als specialisten de technische diagnose overnemen.
- Incidentmanager: bewaakt prioriteiten en bewaart de regie over het hele traject.
- Techlead: stuurt de technische diagnose en oplossing.
- Communicatiemanager: verzorgt updates naar betrokkenen en belanghebbenden.
- Probleemmanager: pakt na het incident de structurele oorzaak op.
Deze verdeling voorkomt dat meerdere personen tegenstrijdige acties nemen tijdens een major incident, zoals Atlassian ook beschrijft voor incidentregie op grotere schaal. De servicedesk blijft daarbij het vaste aanspreekpunt voor de melder, wat voor de klant het gevoel van controle en vertrouwen in stand houdt.
Pro-tip: Documenteer per rol een primair én een back-upcontact, inclusief telefoonnummer: een escalatiepad zonder back-up valt stil zodra één persoon niet bereikbaar is.
Communicatie en rapportage tijdens een incident
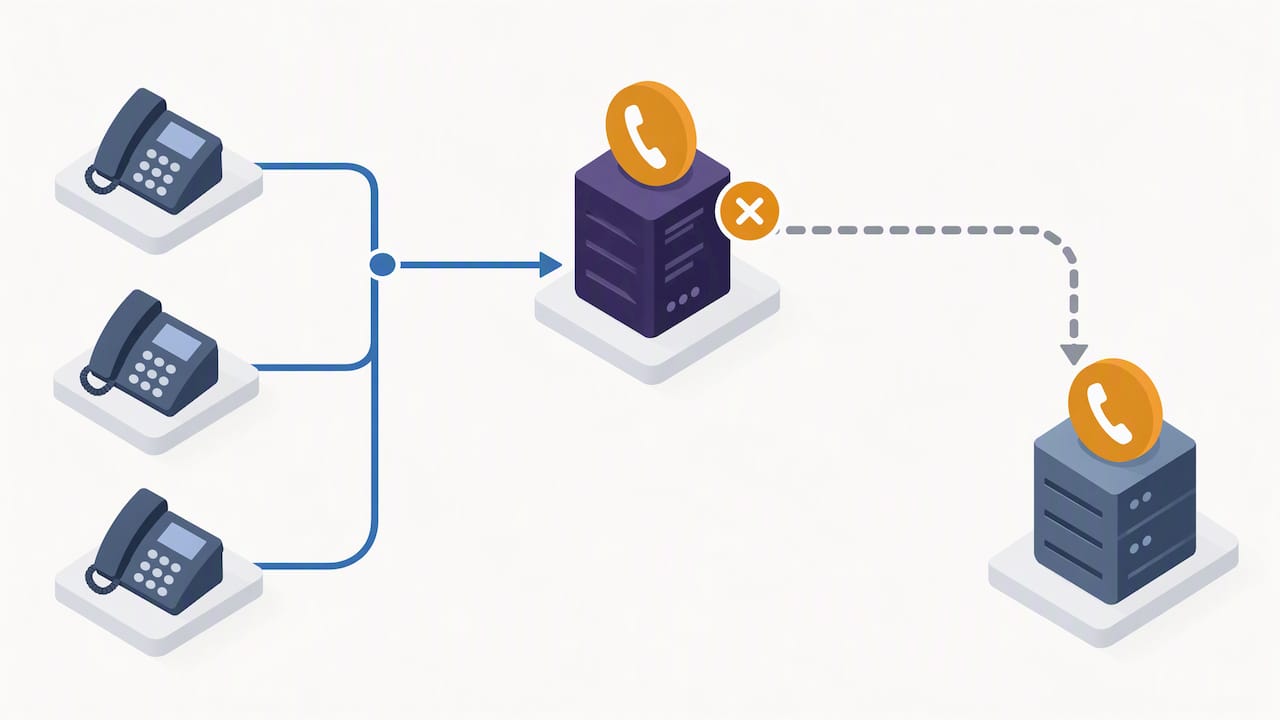
Welk kanaal je gebruikt, hangt af van urgentie en doelgroep. Een statuspagina en pushmelding bereiken grote groepen snel, terwijl telefoon en e-mail geschikter zijn voor individuele afstemming met technische specialisten of management.
- Statuspagina of pushmelding: voor brede, snelle informatie aan alle getroffen gebruikers.
- Telefoon: voor urgente escalatie naar een specifieke rol die direct moet reageren.
- E-mail: voor formele bevestiging, samenvattingen en dossiervorming.
Elk statusbericht bevat minimaal de impact, de genomen acties en een verwachte oplostijd, zodat ontvangers weten waar ze aan toe zijn zonder dat ze erom moeten vragen. Bij beveiligingsgerelateerde incidenten geldt een extra regel: leg nauwkeurig vast welke systemen zijn geïsoleerd en welke stappen zijn genomen, aangezien ISO/IEC 27035-1 bewijsbehoud als onderdeel van de escalatie beschouwt, niet als iets dat achteraf wordt toegevoegd.
Stappenplan: zo richt je een escalatiepad in
Een werkend escalatiepad ontstaat niet vanzelf. Volg deze stappen om het gestructureerd op te zetten.
- Definieer criteria en ernstniveaus: beschrijf per prioriteit (P1 tot P4) wat de impact en urgentie betekenen, met concrete voorbeelden per niveau.
- Stel de escalatiematrix en roosters op: leg per rol de primaire en back-upcontactpersoon vast, inclusief wie overneemt als niemand reageert binnen de erkenningstermijn.
- Bouw runbooks en automatiseringen in je tickettool: verwerk de matrix in een tool zoals Jira Service Management, zodat escalatie na een tijdslimiet automatisch doorgaat in plaats van afhankelijk te zijn van iemand die het opmerkt.
- Oefen met een tabletop-sessie: simuleer een incident op papier om te testen of iedereen zijn rol kent, en stel het proces daarna bij via een vaste PDCA-cyclus (plan, do, check, act).
Een sjabloon dat criteria, niveaus, communicatieprocedures en opvolgacties bevat, geeft een team een kant-en-klare blauwdruk in plaats van improvisatie tijdens een crisis, zoals Atlassian ook aanraadt voor escalatietrajecten.
Pro-tip: Test het escalatiepad minstens twee keer per jaar met een tabletop-oefening: een proces dat alleen op papier bestaat, faalt zodra het echt nodig is.
Nazorg: post-incident review en lessons learned
Een incident is pas echt afgesloten als het team ervan heeft geleerd. Plan een post-incident review kort na het herstel, terwijl details nog vers zijn.
- Reconstrueer het verloop: van eerste melding tot volledige sluiting, inclusief reactietijden per fase.
- Leg verbeteracties vast met eigenaar en deadline: een vage conclusie zonder opvolging verdwijnt in de praktijk.
- Evalueer later of de actie werkt: controleer of de maatregel de doorlooptijd of het risico daadwerkelijk verlaagt, in lijn met de ‘learn lessons’-fase uit ISO/IEC 27035-2.
- Voer bij security-incidenten extra checks uit: controleer of containment en bewijsbehoud correct zijn uitgevoerd voordat het dossier sluit.
Wie structureel met zulke reviews werkt, bouwt in de tijd een steeds completer beeld op van herhalende knelpunten. Meer over het vastleggen van herstelprioriteiten lees je in onze gids over een IT-continuïteitsplan opstellen.
Hoe NLXS escalatie in de praktijk ondersteunt
Bij ons merken we dat een escalatieproces alleen werkt als de servicedesk ook echt snel schakelt, wat aansluit bij praktische tips voor website die de meeste impact hebben op uptime en herstel. Onze aanpak draait om persoonlijke bereikbaarheid en het oplossen van problemen binnen één dag. Diensten zoals ICT-werkplekbeheer en support geven teams een vast aanspreekpunt dat meeloopt in de escalatieketen, van eerste melding tot technische opvolging. Meer basisvragen over onze servicedeskwerking beantwoorden we op onze FAQ-pagina over ICT.
Wat telt het zwaarst bij het inrichten van escalatie?
Regie, back-ups en oefenen wegen het zwaarst. Een escalatieproces zonder geoefende back-up is een papieren proces, en juist die twee factoren bepalen of de doorlooptijd en klanttevredenheid na een incident daadwerkelijk verbeteren.
— Ken
Hoe NLXS kan ondersteunen bij escalatie en herstel
Wanneer een escalatie bij een technisch probleem met hosting, netwerk of werkplek uitkomt, nemen we die laag het liefst volledig over. Onze diensten en support draaien op vaste maandtarieven, met snelle opvolging als uitgangspunt.
- Hosted ICT-werkplekbeheer en serverbeheer: ontzorgt de tweede- en derdelijns technische escalatie.
- Netwerkbeheer: voorkomt dat netwerkincidenten onnodig escaleren naar management.
- ICT-scan: brengt bestaande escalatieknelpunten in de infrastructuur in kaart.
Benieuwd hoe dat voor je organisatie werkt? Bekijk ons aanbod voor hosted ICT en werkplekbeheer en vraag een vrijblijvend gesprek aan.
Veelgestelde vragen
Wat houdt ICT precies in?
ICT staat voor informatie- en communicatietechnologie en omvat alle systemen, netwerken en software die data verwerken, opslaan en uitwisselen. In een servicedeskcontext gaat het concreet om hardware, applicaties, netwerken en telefonie die samen de dagelijkse bedrijfsvoering ondersteunen.
Wat zijn escalerende gesprekstechnieken?
Escalerende gesprekstechnieken zijn manieren om een melding gestructureerd door te geven zonder context te verliezen: herhaal de impact, de al genomen stappen en de tijdsdruk kort en feitelijk bij overdracht. Dit voorkomt dat de ontvangende partij het incident opnieuw vanaf nul moet reconstrueren.
Hoe escaleer ik een ICT-probleem naar het management?
Escaleer naar management wanneer een incident de afgesproken resolve-tijd overschrijdt, reputatieschade veroorzaakt of een compliance- of veiligheidsrisico met zich meebrengt. Meld daarbij kort de impact, de genomen acties en de verwachte oplostijd, zodat een manager direct kan beoordelen of extra inzet nodig is.
Wat is een ICT-helpdesk?
Een ICT-helpdesk, ook wel servicedesk genoemd, is het eerste aanspreekpunt voor meldingen over storingen, vragen of verzoeken rond ICT-systemen.
Bronnen
- ISO/IEC 27035-1:2023 information security incident management (blog excerpt)
- ISO/IEC 27035 guidance and training | PECB
- ISO/IEC/IEEE 23612:2026 | NEN
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.